高校数学「データの分析」公式一覧|分散・相関・時短テクを完全網羅
高校数学Ⅰの中でも、多くの受験生が「計算量の多さ」と「公式の丸暗記」でつまずきやすい単元が「データの分析」です。2025年にスタートした新課程共通テスト以降、単に数値を公式に当てはめるだけの作業から、散布図や箱ひげ図などのビジュアル資料を瞬時に読み解き、効率的な計算手順を選択する実戦的な情報処理能力がシビアに問われるようになりました。
模試や本番の試験会場において、「分散の計算で行き詰まり、大問1つに15分以上溶かしてしまった」「共分散の符号でパニックになった」という苦い経験を語る受験生は後を絶ちません。しかし、本質的な概念のつながりと計算のショートカット術さえ身につければ、この単元は短時間で満点を狙える最強の得点源に変わります。本稿では、必須公式の一覧から計算時間を劇的に削るプロの裏ワザまで、試験直前にも役立つ実践知を凝縮して解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:分散・共分散・相関係数はバラバラに暗記せず、「偏差」「偏差の二乗和」「散らばり」の連鎖で捉えることで計算ミスを根本から防げる。
- 要点2:共通テスト特有の膨大な計算は「二乗の平均-平均の二乗」「仮平均」「変量の変換」を駆使することで処理速度を最大2倍に引き上げられる。
- 要点3:箱ひげ図の視覚的錯覚(ヒゲの長さとデータ数の混同)や外れ値の影響など、作問者が仕掛ける頻出の罠を理論的に見抜く視点が不可欠である。
分散や相関係数でつまずく理由とは?「データの分析」最重要公式一覧と本質
高校数学の「データの分析」で失点する最大の原因は、数式の背景にある「何を測るための値なのか」という統計的な意味を理解せず、記号の並びとして丸暗記しようとする点にあります。まずは、頻出する最重要公式の体系と、その本質的な成り立ちを整理します。
1. 偏差と分散(Variance)の2大公式
各データの値から全体の平均値を引いた差を偏差と呼びます。偏差の合計は常に「0」になるため、散らばり度合いを測るには「2乗」して足し合わせる必要があります。この分子部分を偏差の二乗和と呼びます。
- 分散の定義式:
偏差の二乗の平均値です。データ数を $n$、各データを $x_k$、平均値を $\bar{x}$ とすると、
$$s^2 = \frac{1}{n} \sum_{k=1}^n (x_k - \bar{x})^2$$ - 分散の計算公式(実戦用):
定義式を展開して整理すると、次の極めて重要な関係式が導かれます。
分散 =「二乗の平均」-「平均の二乗」
$$s^2 = \overline{x^2} - (\bar{x})^2$$
平均値が「53.2」のように端数(小数)になる場合、定義式を使うと引き算と二乗の計算で桁数が爆発し、計算ミスの温床になります。この場合は迷わず「二乗の平均-平均の二乗」を使うのが定石です。
2. 標準偏差の求め方(Standard Deviation)
分散は単位が「元のデータの2乗(例:cm²や点²)」になってしまい、直感的な散らばり幅として比較しづらい欠点があります。そこで、分散の正の平方根を取ることで元の単位に戻したものが標準偏差です。
$$s = \sqrt{s^2}$$
3. 共分散の計算方法(Covariance)
2つの変量 $x$ と $y$ の関係性を分析する指標が共分散 $s_{xy}$ です。「$x$ の偏差」と「$y$ の偏差」の積の平均値として定義されます。
- 共分散の定義式:
$$s_{xy} = \frac{1}{n} \sum_{k=1}^n (x_k - \bar{x})(y_k - \bar{y})$$ - 共分散の計算公式:
$$s_{xy} = \overline{xy} - \bar{x} \cdot \bar{y} \quad \text{(「積の平均」-「平均の積」)}$$
共分散が正であれば「$x$ が大きいとき $y$ も大きい傾向(正の相関)」、負であれば「$x$ が大きいとき $y$ は小さい傾向(負の相関)」を示します。
4. 相関係数の公式(Correlation Coefficient)
共分散はデータの単位(cmとm、kgとgなど)を変えるだけで数値が何千倍にも膨らんでしまい、相関の強弱を客観比較できません。そこで、共分散をそれぞれの標準偏差の積で割って規格化したものが相関係数 $r$ です。
$$r = \frac{s_{xy}}{s_x s_y} = \frac{x \text{と} y \text{の共分散}}{(x \text{の標準偏差}) \times (y \text{の標準偏差})}$$
相関係数は単位を持たない無次元量であり、常に以下の範囲に収まります。
$$-1 \leqq r \leqq 1$$
1に近いほど強い正の相関、-1に近いほど強い負の相関、0付近は相関がほとんどないことを表します。
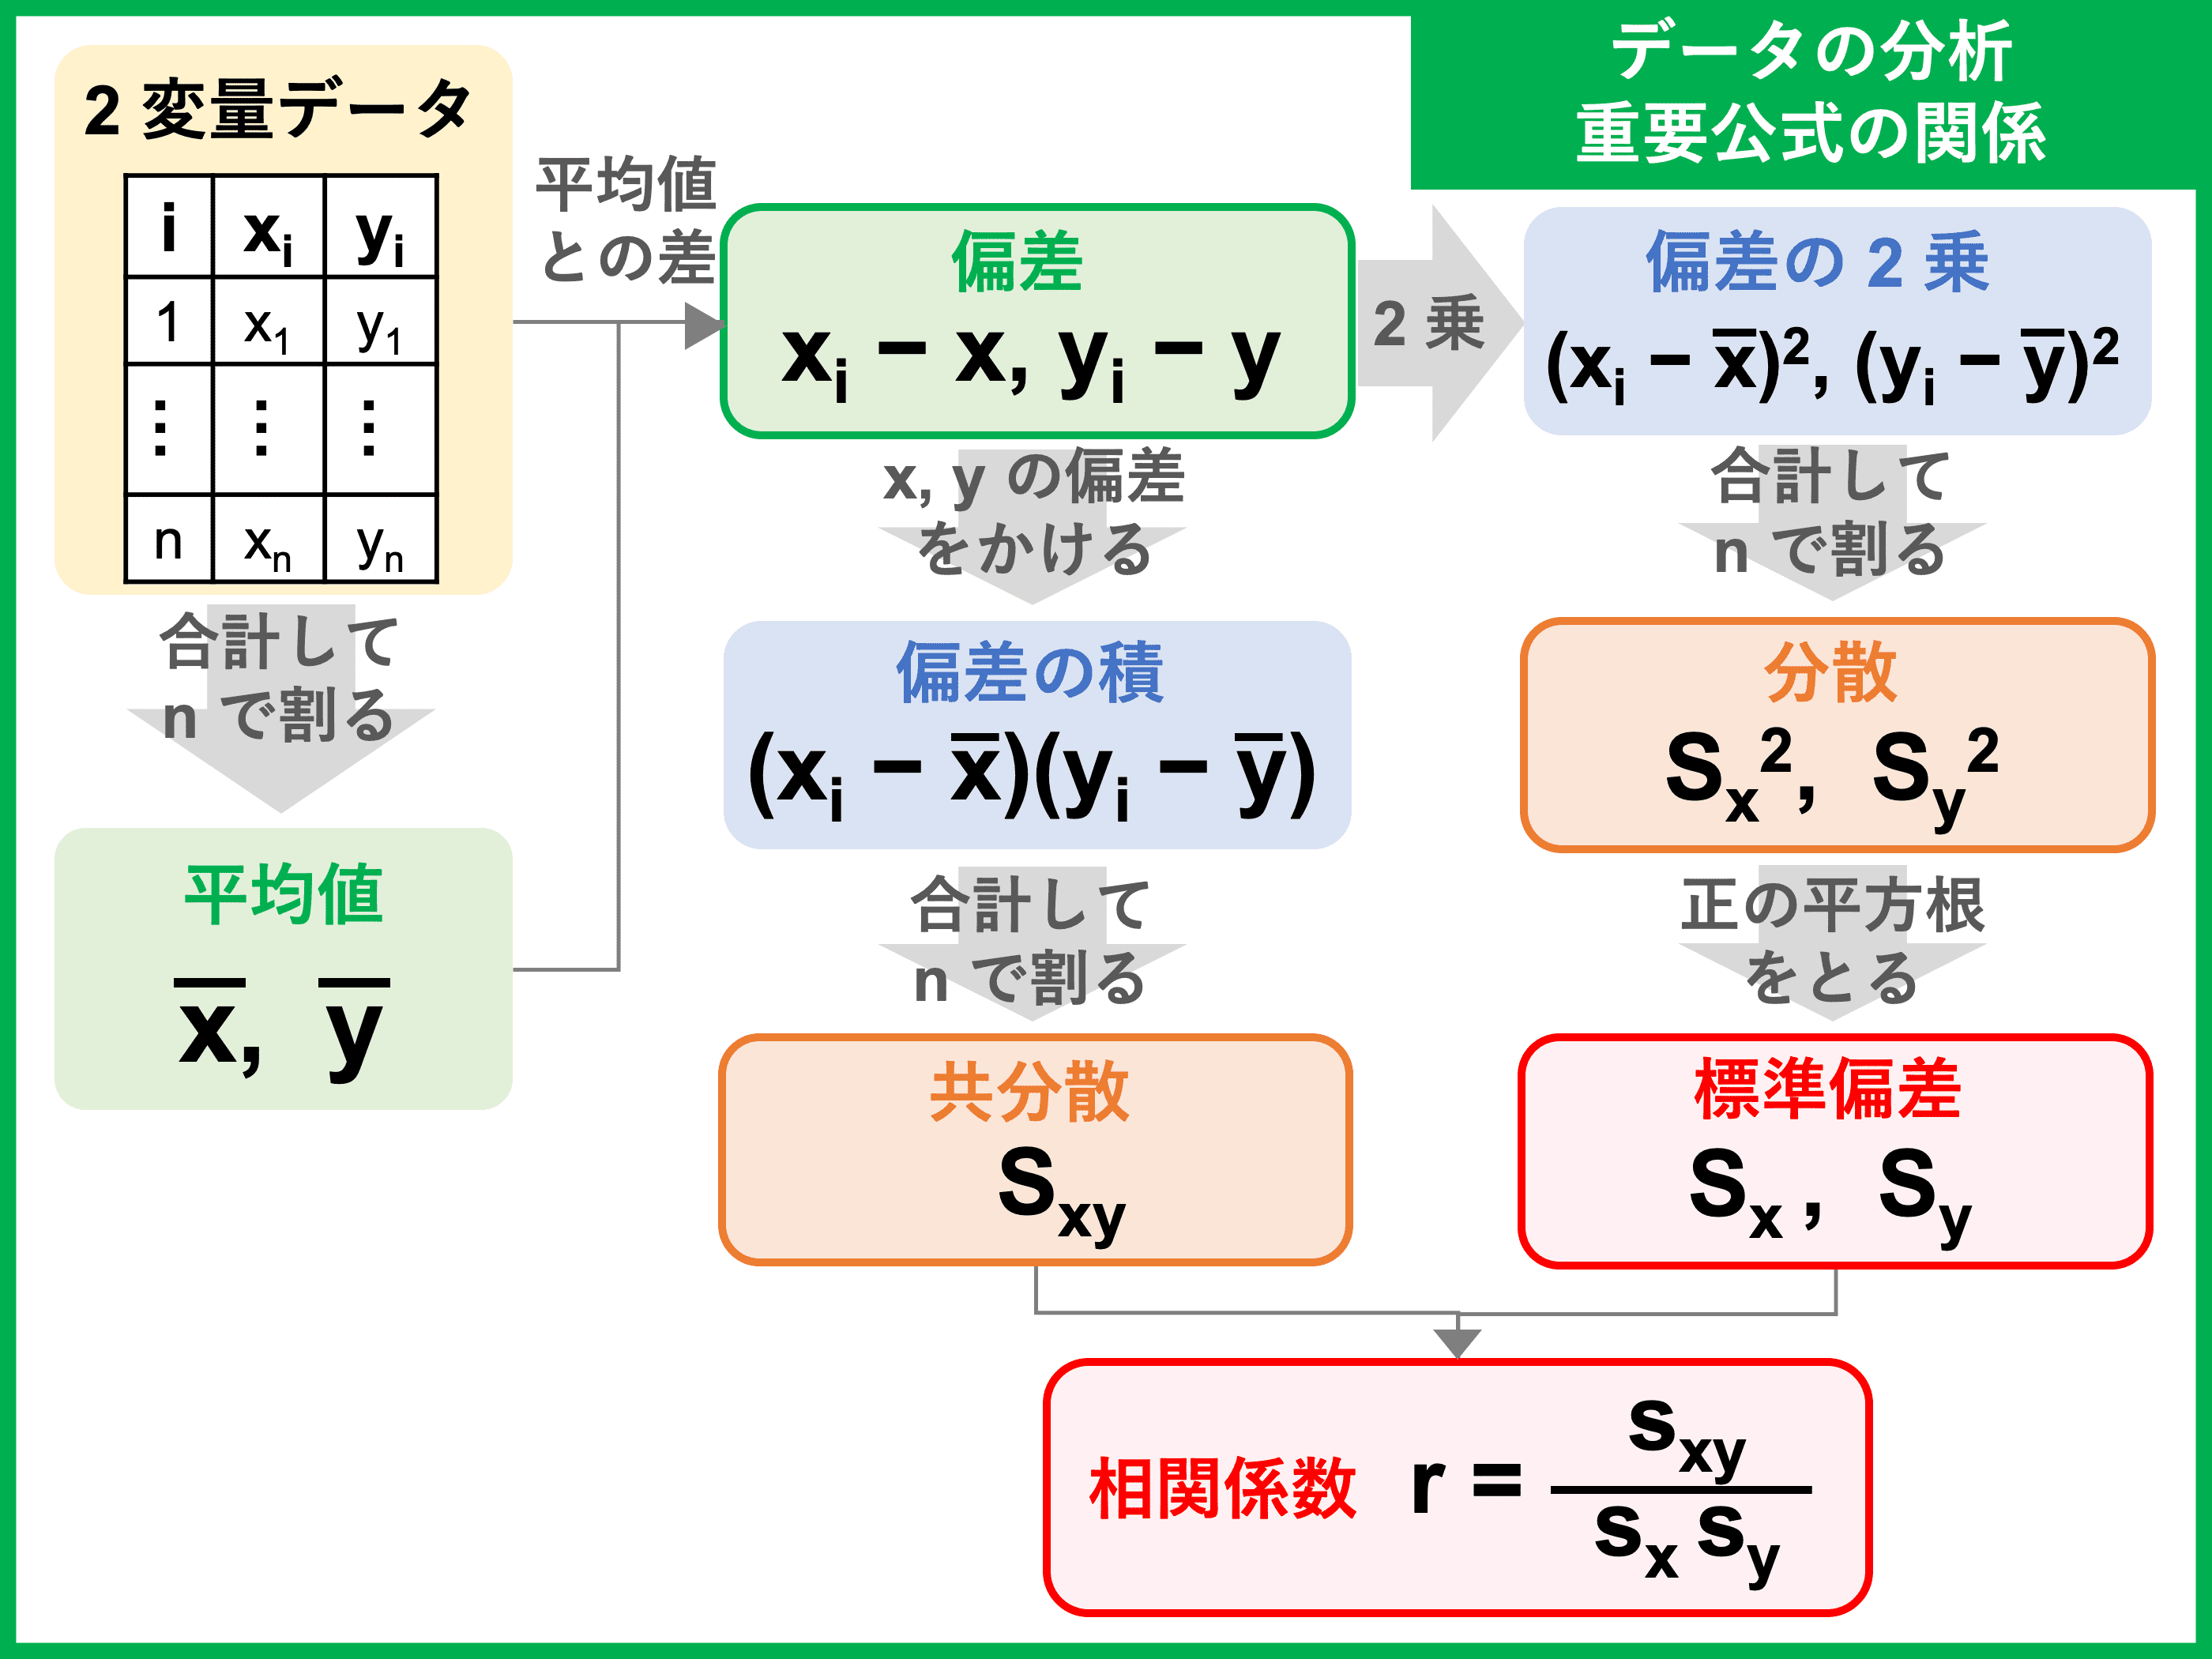
【データ比較】一目でわかる!基本統計量・散らばり・関連性の公式対比表
試験会場で迷いやすい統計量と公式の用途、実戦における重要度を一覧表にまとめました。自分がどの公式の適用で迷っているのかを客観的にチェックしてください。
| 項目・統計量 | 詳細・算出式 | 一般的な基準・数値範囲 | 編集部の見解・実戦評価 |
|---|---|---|---|
| 分散($s^2$) | $\frac{1}{n}\sum(x-\bar{x})^2$ または $\overline{x^2} - (\bar{x})^2$ | 常に $s^2 \geqq 0$ (全データ同値で0) | 平均値が小数のときは計算公式を即座に選択するのが鉄則。 |
| 標準偏差($s$) | $\sqrt{s^2}$ | 常に $s \geqq 0$ 単位は元データと同一 | ルートの近似値計算(開平計算や概算)を素早く行える準備が必須。 |
| 共分散($s_{xy}$) | $\frac{1}{n}\sum(x-\bar{x})(y-\bar{y})$ または $\overline{xy} - \bar{x}\bar{y}$ | 負の実数から正の実数まで (単位依存) | 符号(+/-)の判断だけでも選択肢を2つに絞り込めるケースが多い。 |
| 相関係数($r$) | $\frac{s_{xy}}{s_x s_y}$ | $-1.00 \leqq r \leqq 1.00$ (単位なし無次元量) | 分母の有理化を最後までやらず、散布図の傾き・幅から概算で選ぶのが速い。 |
| 四分位範囲($IQR$) | $Q_3 - Q_1$ | 常に正の実数 中央の50%の散らばり | 箱ひげ図の「箱の長さ」そのもの。外れ値の影響を受けにくい頑健な指標。 |
| 四分位偏差 | $\frac{Q_3 - Q_1}{2}$ | 四分位範囲の半分 | 「四分位範囲」との用語混同が毎年の失点源。2で割るか否かを厳密に確認。 |
計算時間を劇的に削る!知っておくべき「仮平均」と「変量の変換」の時短裏ワザ
共通テストや二次試験の数学Ⅰにおいて、大問にかけられる時間はせいぜい12〜15分程度です。馬鹿正直にすべての数値を3桁×3桁の筆算で解いていては、どれだけ公式を暗記していても時間切れになります。トップ進学校の受験生や予備校講師が実戦で使っている時短テクニックを伝授します。
1. 仮平均の計算テクニック:大きな桁の計算を1桁へ圧縮
例えば、模試の点数データが「168, 172, 175, 169, 181」のように大きな数値で並んでいるとき、これらを直接足し合わせるのは悪手です。基準となりそうな適当な値(この場合は170など)を仮平均 $x_0$ として設定します。
- 各データから仮平均170を引いた差(作業用データ $u_k = x_k - 170$)を求める:
$-2, +2, +5, -1, +11$ - この差の平均 $\bar{u}$ を計算する:
$$\bar{u} = \frac{-2 + 2 + 5 - 1 + 11}{5} = \frac{15}{5} = 3$$ - 真の平均値を復元する:
$$\bar{x} = x_0 + \bar{u} = 170 + 3 = 173$$
さらに重要なのは、「各データから一定の数値を引いても、偏差や分散は一切変わらない」という性質です。分散を求めたい場合、元の「168〜181」ではなく、差分データ「-2, 2, 5, -1, 11」を使って分散を計算できるため、計算量は5分の1以下に圧縮されます。
2. 変量の変換の公式(1次変換):線形変換の完全ルール
変量 $x$ に対して、定数 $a, b$ を用いて $y = ax + b$ という変換を行ったとき、統計量は次のように変化します。このルールは共通テストで頻出中の頻出です。
- 平均値の変化:
$$\bar{y} = a\bar{x} + b \quad \text{(平行移動も倍率もそのまま反映)}$$ - 分散の変化:
$$s_y^2 = a^2 s_x^2 \quad \text{(平行移動 $b$ は消滅し、倍率は2乗される)}$$ - 標準偏差の変化:
$$s_y = |a| s_x \quad \text{(符号を正にするため絶対値が付く)}$$ - 相関係数の変化(最重要):
$u = ax + b$、$v = cy + d$ と2つの変量を変換したとき、変換後の相関係数 $r_{uv}$ は、
$$r_{uv} = \frac{ac}{|ac|} r_{xy}$$
・$a$ と $c$ が同符号(共に正、または共に負)のとき:$r_{uv} = r_{xy}$(全く変わらない)
・$a$ と $c$ が異符号(一方が正で他方が負)のとき:$r_{uv} = -r_{xy}$(符号が反転する)
「気温(℃)を華氏(℉)に変えた」「テストの得点を全員10点底上げした」といったシチュエーション問題では、具体的な再計算を行う必要はありません。上記の変量変換則を適用するだけで、わずか3秒で正解をマークできます。
【実態検証】共通テスト現場の声から見えた「受験生がハマる落とし穴」
大手予備校の模試データや、共通テスト本番直後の受験生コミュニティ・SNSを定点観測すると、受験生が毎年同じパターンで罠に落ちている現実が浮き彫りになります。現場のリアルな証言から見出された3大トラップを検証します。
トラップ1:「偏差の二乗和」をデータ数 $n$ で割り忘れる
「分散を求めたはずが、選択肢にある数値と一桁ズレていてパニックになった」という声が毎年大量に寄せられます。数表を書いて $(x - \bar{x})^2$ を一生懸命に縦に足し算し、その「合計値(偏差の二乗和)」を出した段階で満足してしまい、最後にデータ数 $n$ で割るのを忘れてしまうケアレスミスです。分散はあくまで「二乗の平均」であることを体に染み込ませておく必要があります。
トラップ2:四分位数における「中央値の除外ルール」の誤解
中央値(第2四分位数 $Q_2$)、第1四分位数 $Q_1$、第3四分位数 $Q_3$ を求める際、文部科学省の学習指導要領(高校数学)では「中央値そのものを除いた下位グループ・上位グループのそれぞれで再度中央値をとる」という文科省方式が採用されています。
- データ数 $n$ が奇数(例:7個)の場合:
4番目が中央値 $Q_2$。下位3個(1〜3番目)の中央値(2番目)が $Q_1$、上位3個(5〜7番目)の中央値(6番目)が $Q_3$ となり、4番目のデータは除外します。 - データ数 $n$ が偶数(例:8個)の場合:
4番目と5番目の平均が $Q_2$。下位4個(1〜4番目)の中央値(2番目と3番目の平均)が $Q_1$ となり、境界が綺麗に分かれます。
大学の統計学や一部の表計算ソフト(ExcelのPERCENTILE関数など)では異なる定義式が使われることがあるため、ネット上の解説記事のなかには高校数学のルールと微妙に異なる記述が散見されます。高校の定期試験や大学入試では、必ず文科省方式に則って算出してください。
トラップ3:箱ひげ図の「ヒゲの長さ」をデータ数と錯覚する
箱ひげ図の読み取り問題で最も正答率を落とすのが、「ヒゲや箱が長い=そこにデータがたくさん密集している」という思い込みです。
箱ひげ図における各区間(最小値〜$Q_1$、$Q_1$〜中央値、中央値〜$Q_3$、$Q_3$〜最大値)に含まれるデータ数は、定義上「全体の約25%ずつ(ほぼ均等)」です。ヒゲが長いということは、データ数が多いのではなく、「同じ約25%のデータが広い範囲にまばらに散らばっている(散らばりが大きい)」ことを意味します。この「長さ=密度」という認知バイアスは、共通テストの正誤判定問題で最も狙われやすい急所です。
一般に知られていない盲点とネットの誤解|「公式暗記だけ」で大崩れする理由
ネット上の受験攻略ブログでは「公式に数値を当てはめれば誰でも解ける」といった安易なフレーズが散見されますが、これは明確な誤解です。実際の試験では、数式を暗記しているだけでは絶対に解けない「概念の盲点」を突いた設問が用意されています。
相関係数が「0付近」でも、関係がないとは限らない
多くの受験生が「相関係数 $r \fallingdotseq 0$ だから、$x$ と $y$ には因果関係も関連性もない」と即断して失点します。これは統計学における典型的な誤解です。
相関係数が測定できるのは、あくまで「直線的な関係(線形関係)」の強さだけです。例えば、放課後の勉強時間と疲労度の関係が美しい放物線(2次関数 $y = x^2$)の形状を描いている場合、$x$ と $y$ には完全な数学的関係があるにもかかわらず、左右対称に打ち消し合って相関係数を計算すると「$r \fallingdotseq 0$」になります。「非線形の関係性があるデータ群」に対して相関係数は無力であるという視点は、新課程の記述問題や探究学習型の設問で極めて重視されています。
外れ値が1つあるだけで、平均と相関係数は容易に歪む
データのなかに、誤入力や極端な特異値(外れ値)が1点混ざるだけで、平均値・分散・相関係数は劇的に変動します。これを統計学で「外れ値に対する頑健性(ロバスト性)が低い」と言います。
一方で、中央値や四分位範囲($IQR$)は、外れ値が1つ紛れ込んでもほとんど変動しません。そのため、「外れ値が存在する可能性の高い現実の観測データ」を評価する場合、平均値や標準偏差よりも、中央値や箱ひげ図による分析が優位性を持つケースがあります。共通テストでは「ある生徒の数値を修正した場合、平均・中央値・分散はどう変化するか」という定性的な推論問題が頻出しており、計算ではなくこの性質を問うています。

【プロの結論】確実に得点源にする勉強法と「伸び悩む人・伸びる人」の決定的な差
認知科学および学習心理学の観点から見ると、数学の学習において「数字の意味を視覚情報(メンタルモデル)に変換できる生徒」は長期記憶の定着率が格段に高くなります。「データの分析」で安定して9割以上を叩き出す受験生と、直前で知識が抜け落ちてしまう受験生の間には、思考プロセスに明確な境界線が存在します。
【プロの結論】おすすめできる人・慎重になるべき人の判断基準
- 伸びる人(得点源にできる学習者):
- 「散らばりの大きさを数値化したいから、平均からのズレ(偏差)を2乗して足す」というように、公式の必然性を言葉で説明できる。
- 散布図を見たら、全体の重心($\bar{x}, \bar{y}$)に頭の中で十字線を走らせ、第1・第3象限に点が多いか、第2・第4象限に多いかで共分散の正負を直観できる。
- 問題文を読んだ瞬間、データの個数と桁数を見て「定義式で行くか」「仮平均を使うか」を即断できる。
- 慎重になるべき人(学習法を根本から見直すべき学習者):
- 分散の「$\overline{x^2} - (\bar{x})^2$」を呪文のように暗記し、どちらが「二乗の平均」でどちらが「平均の二乗」か試験中に混同してしまう。
- グラフや図表を見ずに、いきなり余白で力任せの筆算を始めてしまい、時間が足りなくなる。
- 「四分位数」の求め方をデータ数が偶数の場合だけで覚えており、奇数個のデータが出題された瞬間にフリーズする。
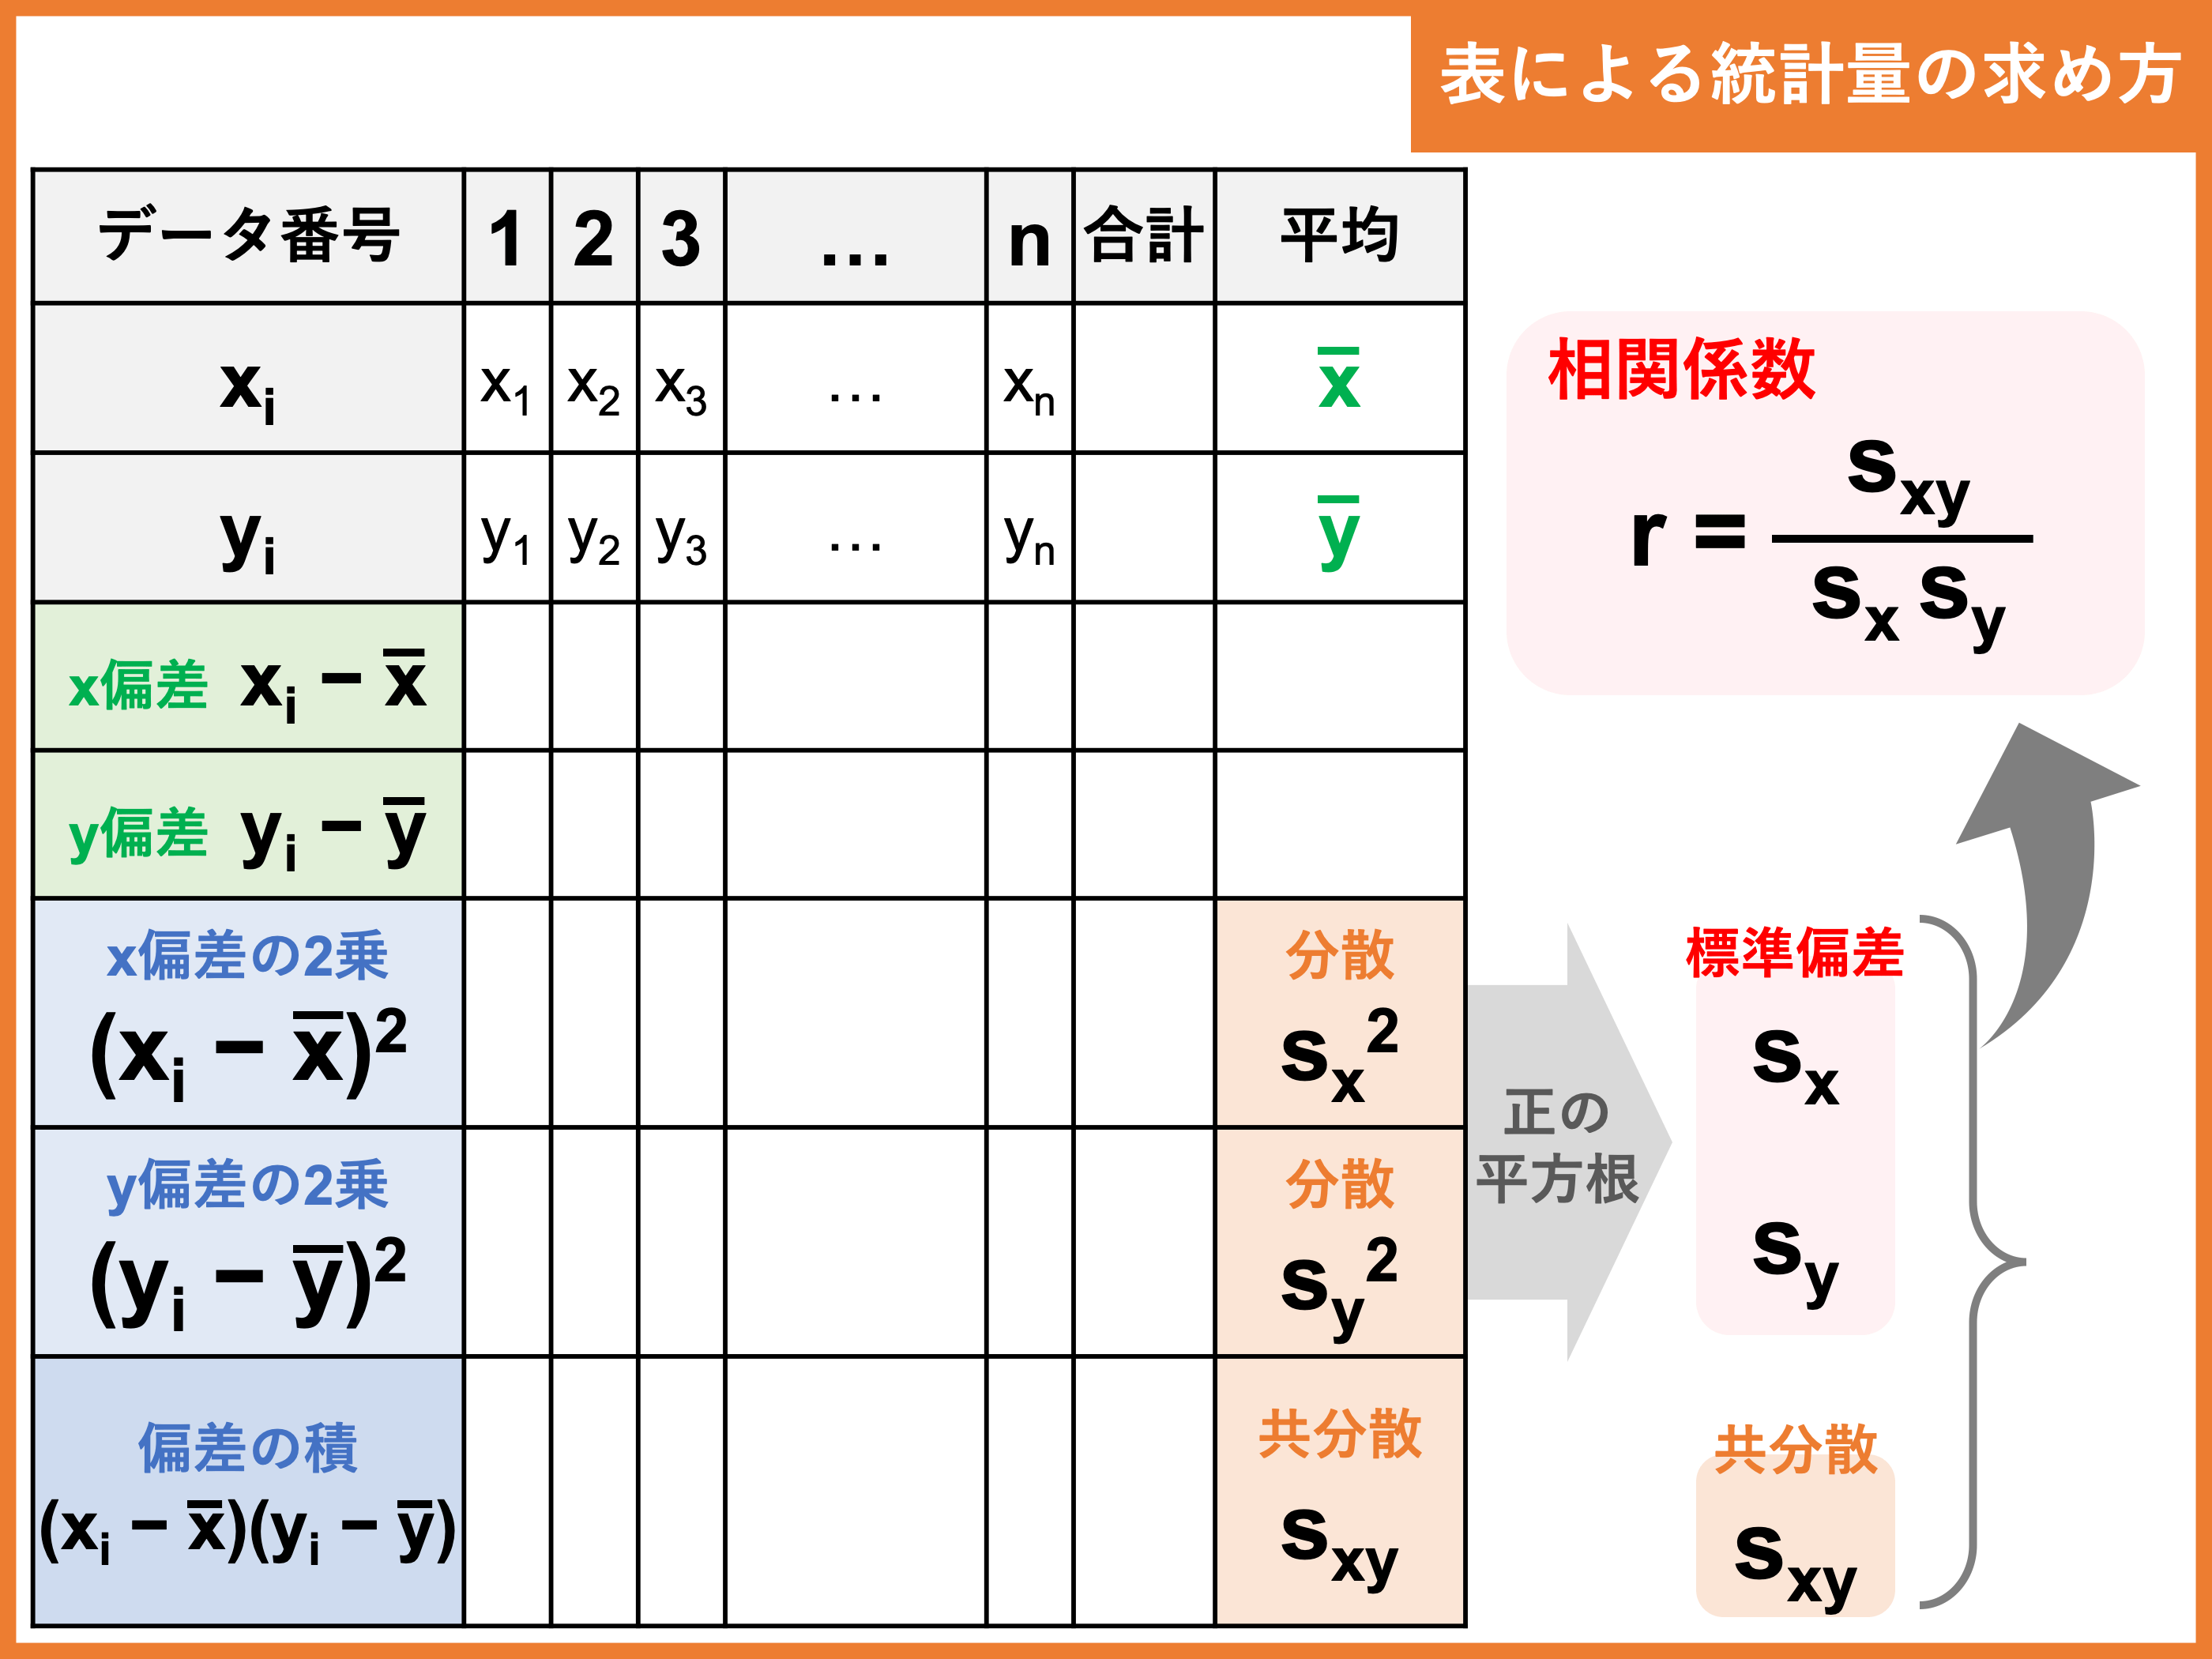
この単元の克服に必要なのは、難解な青チャートの例題を何周もすることではありません。「5〜10個程度の極小のデータセット」を用意し、自分で実際に数表($x, y, x-\bar{x}, y-\bar{y}, (x-\bar{x})^2, (x-\bar{x})(y-\bar{y})$)を手書きして、平均から相関係数までを一気通貫で手計算してみることです。一度自分の手を動かして全体像を俯瞰した経験があれば、どんな変則的な新傾向問題が出題されても、作問者の意図を冷静に見透かすことが可能になります。
【データの分析 公式】に関するよくある質問(FAQ)
Q1:分散の公式は「定義式」と「二乗の平均-平均の二乗」のどちらを優先して使うべきですか?
A1:平均値が「整数」になる場合は定義式、平均値が「小数や分数」になる場合は計算公式(二乗の平均-平均の二乗)を使うのが最も効率的です。平均が小数のときに定義式を使うと、引き算の時点で小数の2乗計算が連続し、計算ミスの確率が跳ね上がります。最初に平均値を求めた段階で、どちらのルートに乗るかを判断してください。
Q2:相関係数を計算したら「1.35」になりました。どこをチェックすべきですか?
A2:相関係数の理論的範囲は $-1 \leqq r \leqq 1$ です。1を超える、または-1を下回る計算結果が出た場合、100%どこかで計算ミスをしています。最も疑うべきは「分母の標準偏差の掛け算ミス」「共分散の符号ミス」「データ数 $n$ での割り忘れ」のいずれかです。試験本番なら、計算をやり直す前に散布図の概形を見て、正負と大体の強さ(0.7〜0.8程度など)から選択肢を絞り込むのが現実的なリカバー策です。
Q3:箱ひげ図の「ヒゲの端」は必ず最小値・最大値になりますか?
A3:高校数学の標準的な箱ひげ図では、ヒゲの左端が「最小値」、右端が「最大値」です。ただし、新課程の探究問題や一部の統計グラフでは、四分位範囲の1.5倍以上離れた数値を「外れ値(黒点など)」として独立表示し、ヒゲの端を「外れ値を除いた最小値・最大値」とするケースがあります。問題文の凡例や注釈に「外れ値の基準」が明記されているか必ず確認する習慣をつけてください。
Q4:共通テスト本番で「データの分析」の大問にかけるべき理想時間は何分ですか?
A4:数学Ⅰ・A全体の中で、データの分析に割くべき時間は「最大でも12分以内」が目標です。全てを愚直に計算すると20分以上かかってしまいます。「仮平均の活用」「変量変換の利用」「相関係数は散布図の形状から概算で選ぶ」という時短スキルをフル活用し、純粋な手計算を最小限に抑える解法手順を確立しておきましょう。
まとめ:本質理解と実戦テクニックで共通テストを完全攻略する
高校数学の「データの分析」は、かつてのような単なる数式処理の暗記科目から、現実の数値を論理的に解釈するリテラシーを問う単元へと完全にシフトしました。複雑に見える公式も、「散らばりを測りたい」「単位の影響を消したい」という統計学の合理的な要請から生まれた道具に過ぎません。
分散の2つの公式の使い分け、変量の変換則による瞬殺テクニック、そして箱ひげ図や散布図の視覚的罠の回避法――これらを正しく体系化して頭に入れておけば、本番の試験で慌てることは一切なくなります。曖昧な丸暗記から脱却し、公式の「意味」と「使いどころ」を鮮やかに結びつける実戦力を武器にして、確実な得点源へと昇華させてください。 (出典: データ の 分析 公式(Yahoo!ニュース))
情報を整理して届けることが得意なWebディレクター。ユーザー視点に立った記事作成を目指しています。